RAG คืออะไร? ให้ AI ตอบจากข้อมูลบริษัทคุณ ลดการตอบมั่ว อ้างอิงได้

สารบัญเนื้อหา12 หัวข้อ · อ่าน 5 นาที
Key Takeaways
- ค้นก่อน แล้วค่อยตอบ RAG ให้ AI ดึงข้อมูลที่เกี่ยวข้องจากเอกสารหรือฐานข้อมูลของบริษัท แล้วใช้ข้อมูลนั้นประกอบคำตอบ แทนการตอบจากความจำของโมเดลอย่างเดียว
- ถูกกว่าและอัปเดตง่ายกว่า Fine-tuning แก้เอกสารในคลังความรู้ AI ก็ตอบตามข้อมูลใหม่ได้ทันที ไม่ต้องฝึกโมเดลใหม่
- คุณภาพขึ้นกับข้อมูลต้นทาง ถ้าเอกสารเก่า ซ้ำซ้อน หรือแบ่งชิ้นไม่ดี คำตอบก็จะพลาด ต้องจัดคลังความรู้ให้ดีก่อน
RAG คือ เทคนิค Retrieval-Augmented Generation ที่ให้ AI "ค้นข้อมูลก่อนตอบ" แทนที่โมเดลภาษาจะตอบจากความรู้ที่จำมาตอนฝึกอย่างเดียว ระบบจะค้นหาข้อมูลที่เกี่ยวข้องจากเอกสาร คู่มือ หรือฐานข้อมูลของบริษัทก่อน แล้วส่งข้อมูลนั้นให้ AI ใช้ประกอบคำตอบ ผลคือ AI ตอบเรื่องเฉพาะของบริษัทได้ เช่น นโยบายการคืนสินค้า สเปกสินค้า หรือขั้นตอนเบิกค่าใช้จ่าย ข้อมูลเป็นปัจจุบัน และบอกได้ว่าคำตอบมาจากเอกสารไหน
RAG คืออะไร
IBM อธิบายว่า RAG เป็นสถาปัตยกรรมที่ช่วยให้โมเดล AI ทำงานได้ดีขึ้น ด้วยการเชื่อมโมเดลภาษาขนาดใหญ่ (LLM) เข้ากับคลังความรู้ภายนอก เพื่อให้คำตอบตรงประเด็นและมีคุณภาพสูงขึ้น
แนวคิดนี้มาจากงานวิจัย "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" ของ Patrick Lewis และคณะ ซึ่งเผยแพร่บน arXiv เมื่อพฤษภาคม 2020 งานวิจัยจับคู่โมเดลสร้างข้อความกับดัชนีค้นหาเอกสาร และพบว่าคำตอบที่ได้เจาะจงและถูกต้องตามข้อเท็จจริงมากกว่าโมเดลที่ใช้ความจำของตัวเองอย่างเดียว
เปรียบง่าย ๆ ว่า LLM เหมือนพนักงานเก่งที่เพิ่งเข้าบริษัท รู้เรื่องทั่วไปมาก แต่ไม่รู้นโยบายภายใน RAG คือการให้พนักงานคนนั้นเปิดคู่มือบริษัทก่อนตอบลูกค้าทุกครั้ง
RAG ทำงานอย่างไร
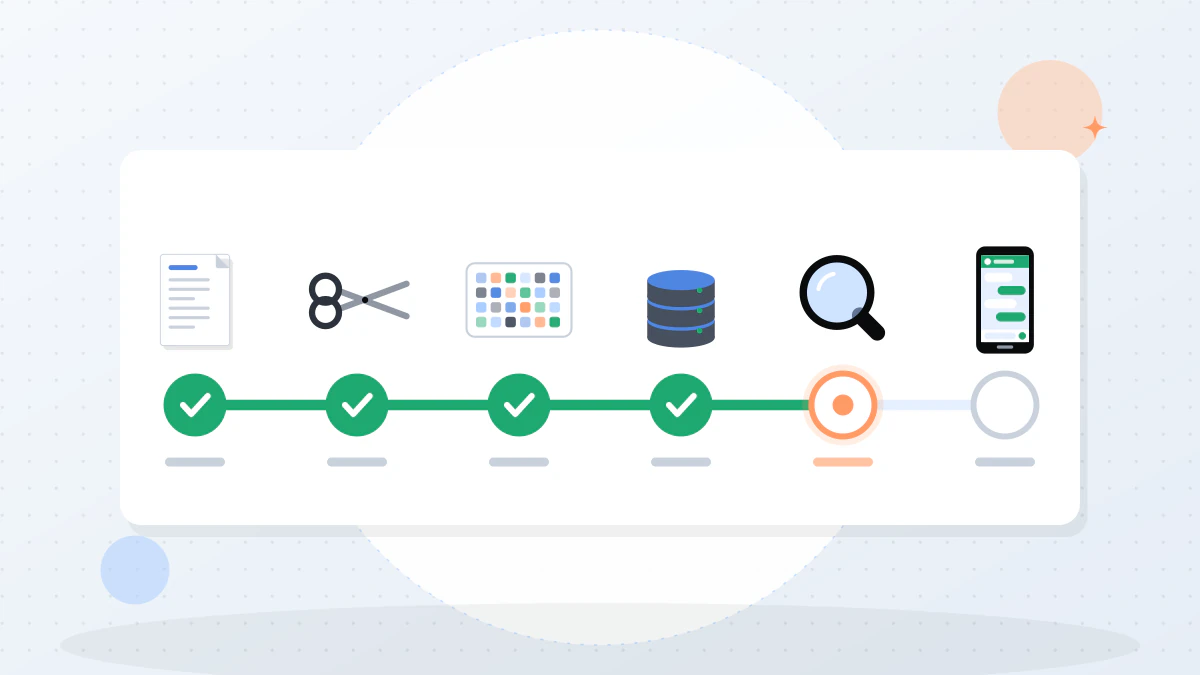
ขั้นเตรียมคลังความรู้ (ทำล่วงหน้า)
- รวบรวมเอกสาร เช่น คู่มือสินค้า FAQ นโยบาย สัญญา และข้อมูลจากระบบหลังบ้าน
- แบ่งเป็นชิ้น (Chunking) หั่นเอกสารเป็นชิ้นขนาดพอเหมาะ IBM ระบุว่าชิ้นใหญ่เกินจะกว้างเกินไป ชิ้นเล็กเกินจะขาดบริบท
- แปลงเป็นเวกเตอร์ (Embedding) แปลงแต่ละชิ้นเป็นชุดตัวเลขที่แทนความหมาย
- เก็บใน Vector Database ฐานข้อมูลที่ค้นหาตามความหมายได้ ไม่ใช่แค่ตามคำ
ขั้นตอบคำถาม (ทุกครั้งที่มีคนถาม)
- ผู้ใช้พิมพ์คำถาม
- ระบบค้นหา (Retriever) หาชิ้นเอกสารที่ความหมายใกล้เคียงกับคำถามที่สุด
- ระบบนำชิ้นเอกสารเหล่านั้นมาต่อเข้ากับคำถาม เป็นคำสั่งที่มีบริบทเพิ่ม (Augmented Prompt)
- LLM สร้างคำตอบจากบริบทนั้น และแนบแหล่งอ้างอิงได้
ประโยชน์ของ RAG
IBM สรุปประโยชน์ของ RAG ไว้ ได้แก่
- ต้นทุนต่ำกว่าการฝึกโมเดลใหม่หรือ Fine-tuning
- ใช้ข้อมูลเฉพาะทางและเป็นปัจจุบันได้ แก้เอกสารแล้ว AI ตอบตามข้อมูลใหม่ทันที
- ลดความเสี่ยงการตอบมั่ว (Hallucination) เพราะมีข้อมูลจริงให้อิง
- อ้างอิงแหล่งที่มาได้ ผู้ใช้ตรวจสอบคำตอบได้ ช่วยเพิ่มความเชื่อมั่น
- ควบคุมง่าย ทีมพัฒนาปรับคลังความรู้ได้โดยไม่ต้องแตะตัวโมเดล
- ความปลอดภัยของข้อมูล ข้อมูลเฉพาะของบริษัทแยกเก็บจากตัวโมเดล
RAG กับ Fine-tuning ต่างกันอย่างไร
| ประเด็น | RAG | Fine-tuning |
|---|---|---|
| หลักการ | ค้นข้อมูลภายนอกมาประกอบคำตอบ | ฝึกโมเดลเพิ่มด้วยข้อมูลเฉพาะทาง |
| อัปเดตข้อมูล | แก้เอกสารในคลังได้ทันที | ต้องฝึกใหม่เมื่อข้อมูลเปลี่ยน |
| ต้นทุนเริ่มต้น | ต่ำกว่า | สูงกว่า ต้องมีข้อมูลฝึกและทรัพยากรประมวลผล |
| อ้างอิงแหล่งที่มา | ทำได้ | ทำได้ยาก |
| เหมาะกับ | ถามตอบจากเอกสาร ข้อมูลที่เปลี่ยนบ่อย | ปรับรูปแบบ น้ำเสียง หรือทักษะเฉพาะของโมเดล |
IBM ระบุว่าสองวิธีนี้ใช้ร่วมกันได้ Fine-tuning ทำให้โมเดลคุ้นกับภาษาและงานของอุตสาหกรรม ส่วน RAG ช่วยให้คำตอบอิงข้อมูลที่ถูกต้องและเป็นปัจจุบัน
ตัวอย่างการใช้ RAG ในธุรกิจ
- แชตบอตบริการลูกค้า ตอบเรื่องสินค้า ราคา การรับประกัน และการคืนสินค้า จากคู่มือจริงของบริษัท
- ผู้ช่วยพนักงานภายใน ถามเรื่องสวัสดิการ ขั้นตอนเบิกจ่าย หรือคู่มือการทำงาน
- ผู้ช่วยฝ่ายขาย ค้นสเปกสินค้า เคสลูกค้าเดิม และราคามาตรฐานระหว่างคุยกับลูกค้า
- งานกฎหมายและเอกสาร ค้นและสรุปข้อสัญญา ระเบียบ หรือมาตรฐานที่เกี่ยวข้อง
- ฝ่ายเทคนิคและซ่อมบำรุง ถามวิธีแก้ปัญหาเครื่องจักรจากคู่มือและบันทึกการซ่อม
RAG มักเป็นส่วนหนึ่งของ AI Agent ด้วย Agent ใช้ RAG เป็น "เครื่องมือค้นข้อมูล" ก่อนตัดสินใจทำงานขั้นต่อไป อ่านเพิ่มเติมได้ที่AI Agent คืออะไร
ข้อจำกัดและความท้าทาย
- ยังตอบผิดได้ IBM ย้ำว่า RAG ลดความเสี่ยงการตอบมั่วได้ แต่ทำให้โมเดลไม่ผิดพลาดเลยไม่ได้
- ต้องดูแลคลังความรู้ต่อเนื่อง เอกสารเก่าหรือขัดแย้งกันทำให้คำตอบผิด
- การแบ่งชิ้นเอกสาร ต้องปรับให้เหมาะกับลักษณะเอกสาร เช่น ตาราง สัญญา หรือ FAQ
- ความปลอดภัยของ Vector Database IBM เตือนว่าถ้าฐานข้อมูลเวกเตอร์ถูกเจาะ ผู้โจมตีอาจย้อนกลับเพื่อกู้ข้อมูลต้นฉบับได้ โดยเฉพาะเมื่อไม่ได้เข้ารหัส
- ข้อมูลองค์กรกระจัดกระจาย ข้อมูลอยู่หลายระบบ ต้องรวมและจัดระเบียบก่อน
- สิทธิ์การเข้าถึง พนักงานแต่ละระดับไม่ควรเห็นเอกสารเดียวกันทั้งหมด ระบบต้องค้นเฉพาะเอกสารที่ผู้ถามมีสิทธิ์
วิธีเริ่มทำ RAG ในองค์กร
- เลือกโจทย์ที่ชัด เช่น ลดคำถามซ้ำที่เข้าฝ่ายบริการลูกค้า หรือให้พนักงานใหม่หาคำตอบเองได้
- คัดเอกสารที่ถูกต้องและเป็นปัจจุบัน เริ่มจากชุดเล็กที่เชื่อถือได้ ดีกว่าโยนทุกไฟล์เข้าไป
- เลือกเครื่องมือ ใช้บริการสำเร็จรูปของผู้ให้บริการ AI หรือสร้างเองด้วยเครื่องมืออย่าง n8n ร่วมกับ Vector Database
- ทดสอบด้วยคำถามจริง เตรียมชุดคำถามพร้อมคำตอบที่ถูกต้อง แล้ววัดอัตราตอบถูก
- ให้ AI แนบแหล่งอ้างอิงเสมอ และกำหนดให้ตอบว่า "ไม่ทราบ" เมื่อไม่พบข้อมูล
- วางระบบอัปเดตเอกสาร กำหนดเจ้าของเอกสารแต่ละหมวด และรอบการทบทวน
ถ้าต้องการให้ผู้เชี่ยวชาญวางระบบ RAG เชื่อมกับข้อมูลองค์กร ดูรายชื่อผู้ให้บริการได้ที่บริษัทรับทำ AI Automation
สรุป
RAG คือเทคนิคที่ให้ AI ค้นข้อมูลจากคลังความรู้ของบริษัทก่อนตอบ ช่วยให้คำตอบถูกต้อง เป็นปัจจุบัน และอ้างอิงได้ ต้นทุนต่ำกว่าการฝึกโมเดลใหม่ และอัปเดตได้ทันทีที่แก้เอกสาร RAG ไม่ได้ทำให้ AI ไม่ผิดเลย ความแม่นยำขึ้นกับคุณภาพเอกสาร การแบ่งชิ้น และการควบคุมสิทธิ์ ธุรกิจควรเริ่มจากโจทย์ชัดและเอกสารชุดเล็กที่เชื่อถือได้ แล้วค่อยขยาย
คำถามที่พบบ่อย (FAQ)
RAG ย่อมาจากอะไร
RAG ย่อมาจาก Retrieval-Augmented Generation แปลตรงตัวว่าการสร้างข้อความที่เสริมด้วยการค้นคืนข้อมูล
RAG Chatbot ต่างจากแชตบอตทั่วไปอย่างไร
แชตบอตแบบเดิมตอบตามสคริปต์ที่ตั้งไว้ แชตบอต AI ทั่วไปตอบจากความรู้ของโมเดล ส่วน RAG Chatbot ค้นเอกสารของบริษัทก่อนตอบ จึงตอบเรื่องเฉพาะขององค์กรได้และอ้างอิงแหล่งที่มาได้
Vector Database คืออะไร
Vector Database คือฐานข้อมูลที่เก็บข้อมูลในรูปเวกเตอร์ตัวเลขที่แทนความหมาย ทำให้ค้นหาข้อความที่ความหมายใกล้เคียงกันได้ แม้จะใช้คำต่างกัน
ทำ RAG ต้องใช้ข้อมูลเยอะแค่ไหน
ไม่จำเป็นต้องเยอะ เริ่มได้จากเอกสารไม่กี่สิบฉบับที่ถูกต้องและครอบคลุมคำถามหลัก คุณภาพและความเป็นปัจจุบันของเอกสารสำคัญกว่าปริมาณ


